Skip to content
  1. Blog
  2. PC & Local AI

PC & Local AI#Ollama#ローカルLLM#RTX 3060

RTX 3060 12GBでOllamaを動かすとき、コンテキスト長とモデル選びはどう決めるか

RTX 3060 12GB+RAM 32GB環境でOllamaを動かす際、GPU使用率93%ではなく専用VRAM空き(8.7/12.0GB)を見て32Kから48Kへ上げる判断と、9B/30B MoEモデルの使い分けを整理した。

Written by the site’s operator1 min read
Ollamaの公式アイコン
ローカルLLMはパラメータ数だけでなく、VRAM 12GBに収まるコンテキスト長の見極めが効く

手元のRTX 3060(VRAM 12GB)+メインメモリ32GBという構成でOllamaを動かし、リポジトリ全体を読ませて複数ファイルをまたぐ開発支援を回していると、「今の設定からコンテキスト長をまだ増やせるか」「どのサイズのモデルを選ぶのが現実的か」という線引きに必ず突き当たる。GPU使用率の表示だけを見て限界だと誤解しがちだが、実際に速度と安定性を決めているのは専用VRAMの空き容量とモデルの構造だ。

1. GPU使用率ではなく「専用VRAM 8.7 / 12.0 GB」を見る

タスクマネージャや監視ツールで「GPU使用率 93%・温度 67度」と出ていると、一見するとマシンが限界スレスレで悲鳴を上げているように見える。しかしLLMの推論中はGPUコアをフル回転させるため、使用率が90〜100%に張り付くこと自体は正常な挙動だ。

コンテキスト長(Context Length)を増やす余地があるかを見極めるうえで本当に見るべきなのは、専用VRAMの使用量になる。実測で専用VRAMが 8.7 / 12.0 GB(空き約3.3GB・共有GPUメモリ 0.8 / 16.0 GB)に収まっている状態なら、まだ3GB以上の余裕がある。32K前提で動かしている環境なら、まず48Kへ引き上げてもVRAM内に収まりきる可能性が高い。
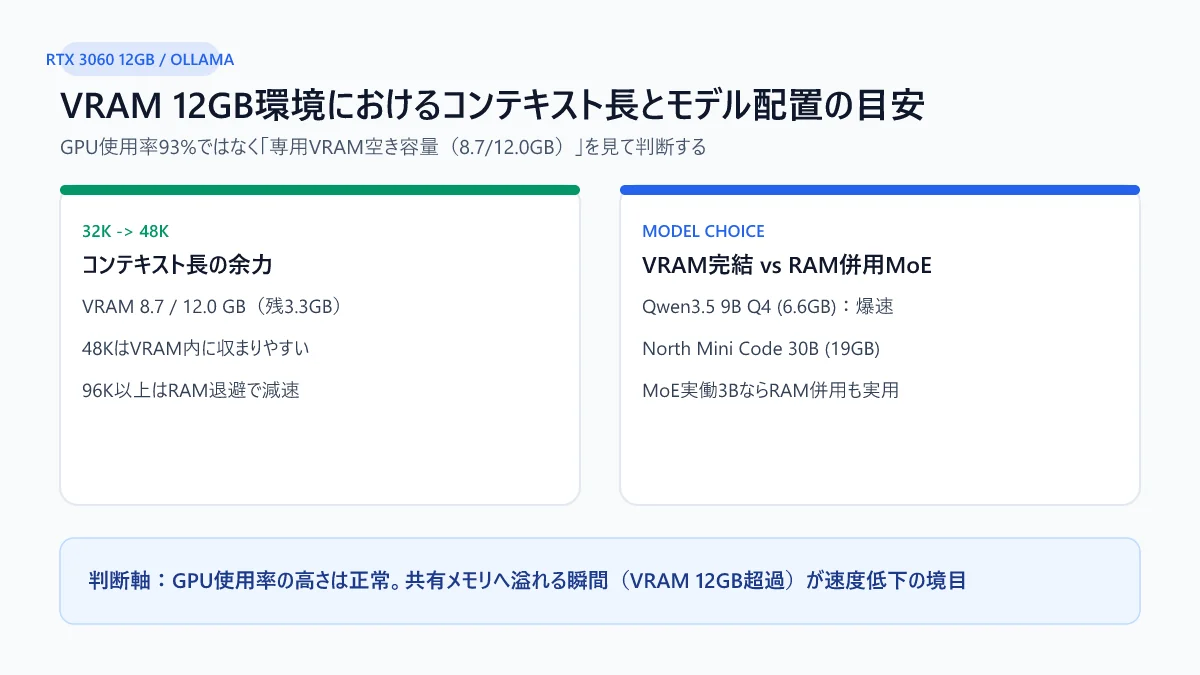
RTX 3060 12GB環境でのVRAM空き容量とコンテキスト長(32K/48K/96K)および9B/30B MoE比較図
専用VRAM 8.7/12.0GBの余裕があれば48Kまで伸ばせる一方、96K以上はRAM退避で急減速する

2. コンテキスト長の現実的な境界とモデル選定

ただしコンテキスト長は増やせば増やすほどKVキャッシュがVRAMを食い潰すため、12GB GPUには越えると急激に遅くなる境界がある。

設定・モデル例VRAM / RAM 占有の目安RTX 3060 12GB での動き
32K context8.7 GB 前後かなり余裕があり安定・高速
48K context10〜11.5 GB 前後おすすめ。VRAM内に収まりやすい
96K〜128K context12 GB 超過共有RAMへ退避し、生成速度が大きく低下
Qwen3.5 9B Q4(6.6GB)VRAM内で完結圧倒的に軽く速い。日常の実装ループ向き
North Mini Code 1.0 30B(19GB Q4)RAM併用(MoE実働約3B)大規模読解・計画向き。速度と知能の妥協点

3. WSL+開発エージェント設定変更時の再起動トラップ

WSL環境でOpenCode等のエージェントとOllamaを連携させているとき、--headless 設定の変更やコンテキスト上限の書き換えを行っても、すでに起動済みのMCPプロセスには設定が反映されないことがある。

動作が切り替わらないときは「実行中タスクを Ctrl+C で停止 → エージェントを一度終了 → 設定変更 → 再起動」という手順を踏むのが確実だ。タスクの進行状態自体はコード側の保存済みファイルに残るため、再起動後に「続きから現在の変更を確認して進めて」と指示すれば問題なく復旧できる。

4. VRAM 12GB環境を長く快適に回す基準

RTX 3060 12GBは「48K前後までの9B〜14B量子化モデルを完全VRAM内で高速に回す」のが最も得意な領域だ。共有メモリへ溢れさせて1トークン数秒待ちになるより、VRAM枠に収まるコンテキスト長とモデルサイズを見極めて回転数を上げる方が、結果的に開発のテンポが良くなる。

手元のブラウザ側でのマシン処理感や負荷の基準を見たいときは、端末ベンチマークツールで環境ごとの処理速度を測っておくと比較しやすい。
Share this article
Share on X

Read next

Maker & Vision

Mac特定ウィンドウOCRが空文字を返す原因。Quartz+Tesseractの前処理とROI選択

Macでpyobjc(Quartz)とpytesseractを使って特定ウィンドウの文字を読む際、結果が空になった原因(文字サイズ・コントラスト不足)とselectROI・拡大・二値化での改善をまとめた。

#OCR#Python
Essays & Notes

AI文章っぽい定型句を避けて、ChatGPT過去ログの「実測と失敗」を一次記事にする

AI生成文章に出やすい導入定型句の傾向を確認しつつ、一般論の焼き直しではなく自分のChatGPTエクスポートに眠る実機検証や失敗談をブログ記事へ起こす編集方針をまとめた。

#ライティング#ブログ運営
Network

VPNはどこまで通せて、なぜ全部は抜けないのか。TrueNAS上のTailscaleが学校フィルタリングで止まる仕組み

「VPNを繋げばどんな制限も回避できる」わけではない理由を、Tailscale(WireGuard)の通信構造・Exit Node・UDP遮断・DPI(ディープパケットインスペクション)・VPNプロトコルごとの違いから整理した。

#VPN#Tailscale
Essays & Notes

なぜ減価償却で「100万円使って赤字」ではなく1円(備忘価額)を残すのか

設備投資した年の現金支出(キャッシュフロー)と本業の稼ぐ力(損益計算)を切り分ける減価償却の意味と、償却完了後に帳簿へ1円(備忘価額)を残す理由、建物の定額法統一を整理した。

#会計#減価償却
Essays & Notes

「6時半」に違和感がないのにデンマーク語の20進数を奇妙に感じるのはなぜか

時(24進)+分(60進)+半(2進)の雑種である「6時半」は自然なのに、デンマーク語の50・70・90の20進数表現を難しく感じる理由を「パターン認識と文化バイアス」から考察した。

#数学#認知科学
Maker & Vision

Bambu Lab「ホリデーPETGお楽しみBOX」4,840円の開封結果とまとめ買い最大45%OFFの単価比較

Bambu LabのホリデーPETGお楽しみBOX(4,840円・4kg)の実際の開封結果(Basic Yellow / Matte White / Translucent Teal / Basic Navy Blue)と、通常まとめ買い(最大45%OFF)の単価・質感比較をまとめた。

#3Dプリンタ#Bambu Lab

All articles