クラウド型のAIコーディングツールを使っていると、「時間がかかってもいいから、手元のゲーミングPCで回数制限や利用枠を気にせずに動かせるローカル環境を作れないだろうか」と考えることがあります。実際に手元にある RTX 3060(VRAM 12GB)/ メインメモリ 32GB の環境を前提に、自律型のコーディングエージェントとしてどこまで実用になるのかを調べて整理しました。
VRAM 12GBで動かせるモデルと、現実的な動作感
コーディング向けのオープンソースモデル(Qwen2.5-Coder など)をローカルで動かす場合、GPUのVRAM容量(12GB)にどこまで収まるかで速度と実用性が大きく変わります。
| モデル規模 | RTX 3060 (12GB) での動作感 | コーディングでの得意・不得意 |
|---|---|---|
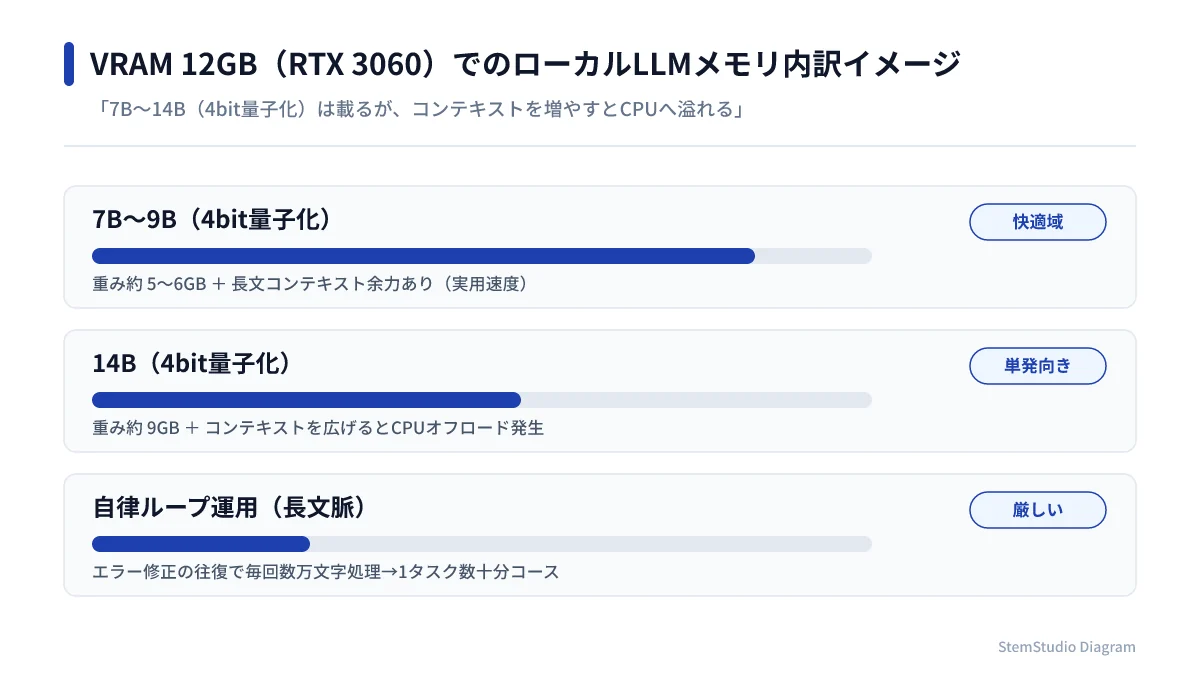
| 7B〜14Bクラス(量子化版) | VRAM内に収まり、かなり速く返ってくる | 単発の関数作成やリファクタリングは実用的。複数ファイルにまたがる修正は文脈を落としやすい |
| 32Bクラス(4bit量子化) | VRAM 12GBに収まりきらずRAMへ逃げるため遅くなる | 賢さは大きく上がるが、自律ツールとして何十回もやりとりを回すと待ち時間が長くなる |
なぜ「思考に時間がかかってもいい」だけでは解決しにくいか
最初は「1回答に数分かかっても、放置しておけば完成するならそれでいい」と思いがちです。ただ、自律型コーディングエージェントをローカルの小・中規模モデルで回すと、速度以上に「長いやりとりでの破綻」がネックになりやすくなります。
自律開発では「エラー文を読む → 該当ファイルを開く → コマンドを正しい形式で呼ぶ → 修正して再テストする」というステップを何十回も連続してこなす必要があります。コンテキスト(会話履歴)が長くなってきたときに、14B以下のモデルだと途中の前提を忘れたり、同じ修正をループしたりする確率が上がってきます。
RTX 3060 12GBで現実的に使える落とし所
すべてをローカルモデル1本に丸投げしようとすると厳しい場面が出ますが、用途を切り分けるとかなり便利に使えます。
- エディタの補完・小規模なコード書き換えをローカルにするOllamaなどで14Bクラスのモデルを立てておき、「この関数のエラー処理を書いて」「この処理をテストコードにして」といった局所作業を手元でこなす形なら、速度も精度も十分実用的です。
- 設計や複雑なデバッグはクラウド側に任せるファイル全体を横断して原因を追う作業や要件定義はクラウドの大型モデルを使い、細かい実装や試行回数の多い部分はローカルで回す、と役割を分けるとコストと精度のバランスが取りやすくなります。
手元PCで画像生成などを回すときと同じように、「自分のVRAM容量で無理なく得意な仕事だけを任せる」のが、ローカル環境を長く快適に使うコツになりそうです。同じGPU環境で使えるローカル画像生成AIのはじめ方もあわせて参考にしてみてください。